

Marketing
Equipo de agentes de IA para marketing: quien escribe no aprueba

Mariángeles Leiva Luque
Publicado el · 9 min
La respuesta corta
Un equipo de agentes de IA para marketing funciona cuando cada agente tiene un solo rol y nadie controla su propio trabajo: un agente redacta, otro distinto lo revisa contra una lista cerrada y una persona aprueba lo que sale hacia el cliente o hacia la tienda. La regla tiene respaldo: un estudio de Panickssery, Bowman y Feng publicado en arXiv en 2024 encontró que los modelos de lenguaje tienden a puntuar mejor sus propios textos que los ajenos, aunque personas evaluadoras los consideren de igual calidad.
Anthropic, OpenAI y Google describen el mismo esquema en su documentación oficial para construir agentes: un generador, un evaluador separado y puntos de control humano para las decisiones sensibles. Acá te cuento cómo lo aplicamos en la agencia para que lo copies en tu tienda online.
De dónde sale la idea: el equipo de agentes de Piperz
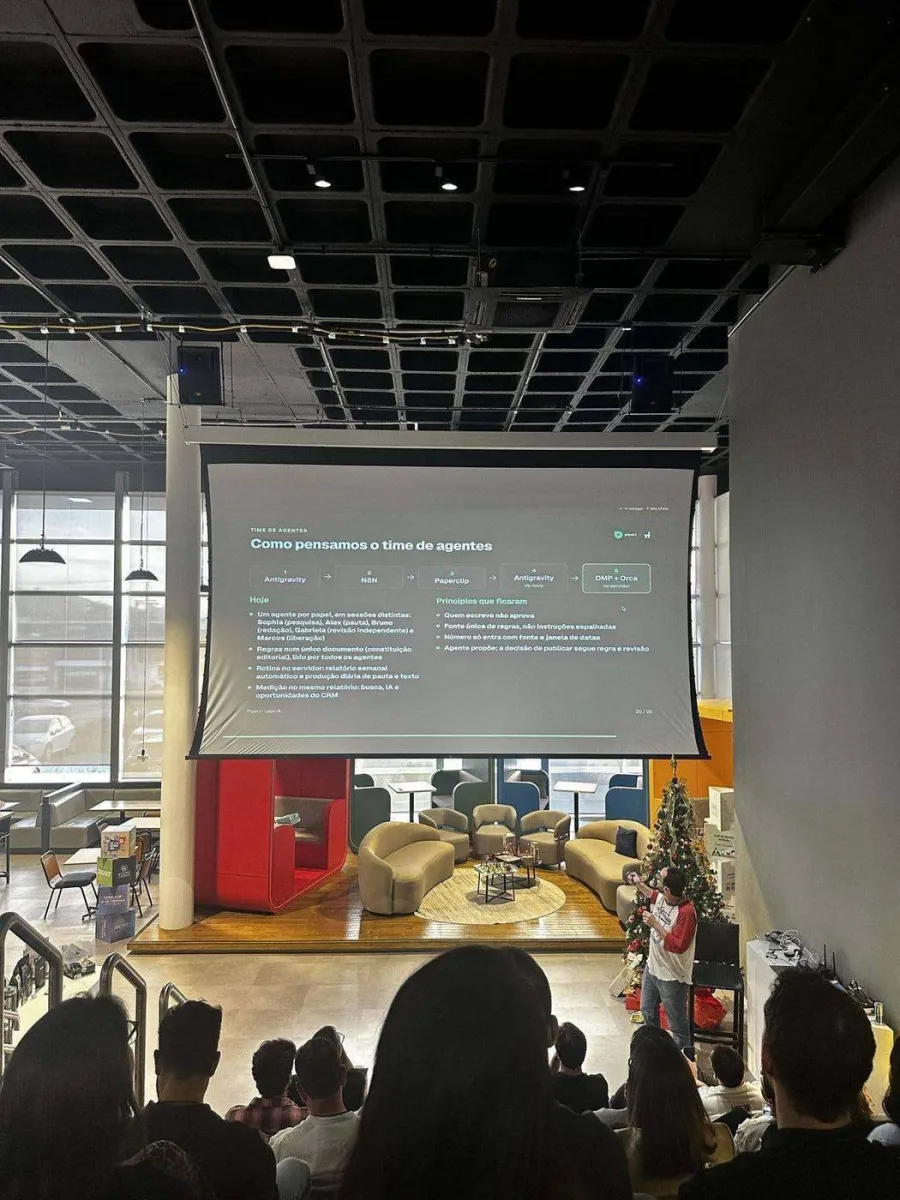
El 12 de noviembre fui al Growth Lab 3ª edição en Florianópolis (lo conté completo en las 7 ideas que me traje del Growth Lab). Michell Lech, CMO de Piperz y fundador de Alpaca Labs, mostró cómo arman su contenido con un equipo de agentes.
Cada agente tiene un papel y trabaja en una sesión distinta: uno investiga, otro arma el temario, otro redacta, otro hace una revisión independiente y otro libera la publicación. Todos leen las reglas de un único documento, al que llaman constitución editorial. Los cuatro principios que les quedaron después de varias pruebas de herramientas fueron estos:
Quien escribe no aprueba.
Una sola fuente de reglas, en lugar de instrucciones repartidas en muchos lugares.
Un número solo entra con fuente y rango de fechas.
El agente propone; la decisión de publicar sigue una regla y una revisión.
Para tu tienda: antes de sumar herramientas, escribí en una hoja quién hace cada tarea y quién la controla. Si la misma persona (o el mismo agente) hace las dos cosas, ahí está el primer riesgo.
Por qué el que escribe no puede aprobar
Hay tres estudios con metodología que lo explican.
El primero es el estudio sobre autopreferencia que ya mencioné. Probaron modelos como GPT-4 y Llama 2 como evaluadores y encontraron un sesgo de autopreferencia: el modelo puntúa mejor lo que escribió él mismo. Además, cuanto mejor se reconoce a sí mismo, más fuerte es el sesgo.
El segundo se presentó en ICLR 2024 y se titula, traducido, los modelos de lenguaje todavía no pueden autocorregir su razonamiento. Su conclusión es que, sin una señal externa, a los modelos les cuesta corregir sus respuestas y a veces empeoran después de intentarlo.
El tercero analizó por qué fallan los sistemas con varios agentes. Los autores de la taxonomía MAST de fallas en sistemas multiagente (Cemri y otros, 2025) reunieron más de 1.600 ejecuciones anotadas en 7 marcos de trabajo populares y definieron 14 modos de falla. Una de sus tres categorías es la verificación de la tarea. También advierten que, en los benchmarks populares, la mejora de usar varios agentes suele ser mínima: sumar agentes sin diseño no garantiza nada.
| Estudio | Qué midió | Qué significa para tu equipo |
|---|---|---|
| Panickssery y otros, 2024 | Si un modelo prefiere sus propios textos | El revisor tiene que ser otro agente y, si podés, otro modelo |
| Huang y otros, ICLR 2024 | Si un modelo se corrige solo, sin ayuda externa | La revisión necesita criterios externos (una lista, una fuente) |
| Cemri y otros, 2025 (MAST) | Por qué fallan los sistemas multiagente | La verificación es un paso propio, con dueño |
Qué hacer: dejá de pedirle al mismo chat "revisá lo que escribiste". Abrí otra sesión, pasale solo el texto y la lista de control.
Qué dicen Anthropic, OpenAI y Google
Las tres empresas coinciden en el diseño, cada una con su propio nombre para el patrón.
Anthropic, en su guía de ingeniería sobre cómo construir agentes efectivos (diciembre de 2024), describe el patrón evaluador y optimizador: un modelo genera una respuesta y otro la evalúa y le devuelve comentarios en un ciclo. Aclara que funciona mejor cuando hay criterios de evaluación claros. También recomienda empezar por la solución más simple posible y sumar complejidad solo cuando hace falta.
OpenAI, en su guía práctica para construir agentes, lanzada en abril de 2025, pide planificar la intervención humana en dos casos: cuando el agente supera un límite de reintentos y cuando la acción es sensible, irreversible o de alto impacto (sus ejemplos son cancelar pedidos, autorizar reembolsos grandes o hacer pagos). Su recomendación general es sacarle el máximo a un solo agente antes de dividir el trabajo en varios.
Google, en la documentación de su Agent Development Kit sobre patrones de trabajo con varios agentes, lista el patrón de generar y revisar (un agente generador y un agente crítico), el refinamiento iterativo con un número máximo de vueltas y el patrón con una persona en el circuito para supervisar, aprobar o corregir.
| Empresa | Nombre del patrón | Qué recomienda |
|---|---|---|
| Anthropic | Evaluador y optimizador | Un modelo genera, otro evalúa con criterios claros |
| OpenAI | Intervención humana | Persona obligatoria en acciones irreversibles o de alto impacto |
| Generar y revisar, persona en el circuito | Agente crítico separado y tope de iteraciones |
Qué hacer: antes de armar nada, escribí tus criterios de evaluación. Si no podés escribir qué está bien y qué está mal, el agente revisor tampoco va a poder decidirlo.
Cómo trabajamos en We make it Lab
En la agencia aplicamos la misma regla de tres pasos en los entregables que pasan por IA: textos del blog, copys, reportes y piezas para redes.
Un agente redacta. Sigue un manual escrito (nuestra versión de la constitución editorial) con el tono, las fuentes permitidas, lo que está prohibido decir y el formato. Ese manual vive en skills de Claude, así no depende de que alguien se acuerde de pegar las instrucciones.
Otro agente distinto hace el control de calidad. Corre en una sesión aparte, sin el historial del redactor. En Claude Code eso se resuelve con subagentes, que según la documentación de Anthropic corren en su propia ventana de contexto y con permisos independientes. El revisor chequea contra una lista: que cumpla el pedido, tildes, que cada número tenga fuente, que los links funcionen y que no haya rastros típicos de redacción con IA. Tiene un máximo de dos vueltas. Si después de eso sigue con errores, el entregable queda marcado para revisar y no avanza.
Una persona aprueba lo que va al cliente. La account manager o yo miramos el resultado antes de enviarlo. Lo mismo con las cuentas de anuncios: un agente puede leer los datos de Meta o Google (contamos cómo los conectamos en cómo conectar Claude a tu CRM o ERP con MCP), pero subir un presupuesto o pausar una campaña lo decide una persona.
Esta nota pasó por ese mismo circuito antes de llegar al blog.
Qué hacer: si ya usás IA en tu equipo, sumá un solo paso: un revisor separado con una lista de diez puntos. En la agencia fue el cambio más simple de sumar.
Cómo armar tu equipo de agentes en 5 pasos
Para una tienda online, el equipo completo tiene cuatro roles:
| Rol | Qué hace | Qué no puede hacer | Ejemplo en una tienda |
|---|---|---|---|
| Investigador | Junta datos con fuente | Escribir el texto final | Revisa preguntas frecuentes y reseñas |
| Redactor | Escribe siguiendo el manual | Aprobar su propio texto | Arma la ficha de producto o el mail |
| Revisor | Controla contra la lista | Reescribir el estilo a gusto | Verifica precio, cuotas, envío y tildes |
| Persona aprobadora | Decide qué sale | Delegar lo irreversible | Publica la ficha o lanza la campaña |
Elegí una tarea repetible. Fichas de producto, copys de anuncios o mails post compra. Una sola para empezar: tanto Anthropic como OpenAI recomiendan arrancar simple.
Escribí la constitución. Un documento único con tono, claims prohibidos, de dónde salen precios y cuotas, y qué datos necesitan fuente. Lo explicamos en cómo implementar Claude en una empresa.
Separá redactor y revisor. Sesiones distintas, y el revisor solo recibe el texto y la lista.
Definí qué aprueba siempre una persona. Todo lo que llega al cliente final, los precios y cualquier cambio de presupuesto en la pauta de tu tienda.
Poné un tope de vueltas y medí el costo. Anthropic informó en su artículo sobre su sistema de investigación con varios agentes (junio de 2025) que ese sistema superó por 90,2 % a un agente solo en su evaluación interna, pero que los sistemas multiagente usan cerca de 15 veces más tokens que un chat.
Qué hacer: arrancá con redactor y revisor. Sumá investigador y orquestador solo si el volumen lo pide.
Qué no conviene hacer
Instrucciones repartidas en diez prompts. Cuando cambia una regla, nadie sabe dónde actualizarla. Una sola fuente.
Dejar que un agente publique o toque presupuesto sin una persona. Mover plata es el tipo de acción que OpenAI marca como de alto riesgo.
Arrancar con seis agentes. Más agentes suman costo y puntos de falla, como muestra el estudio MAST.
Números sin fuente. Si el revisor no puede abrir la fuente y confirmar el dato, el dato no entra.
Conclusión
Un equipo de agentes de IA para marketing rinde cuando separa roles: uno produce, otro controla con criterios escritos y una persona decide lo que mueve plata o llega al cliente. Es la regla que mostró Piperz en el Growth Lab y la que aparece en la documentación de Anthropic, OpenAI y Google.
Si querés llevar este esquema a tu equipo, tenemos una capacitación en Claude Code para equipos y armamos automatizaciones a medida. Y si tenés una tienda online y querés saber dónde se te escapa la plata en la pauta, pedinos un diagnóstico de tu cuenta de 30 minutos.
Fuentes consultadas
LLM Evaluators Recognize and Favor Their Own Generations, Panickssery, Bowman y Feng, arXiv, abril de 2024 (consultada el 15-nov-2026).
Large Language Models Cannot Self-Correct Reasoning Yet, Huang y otros, ICLR 2024 (consultada el 15-nov-2026).
Why Do Multi-Agent LLM Systems Fail?, Cemri y otros, arXiv, marzo de 2025, revisión de octubre de 2025 (consultada el 15-nov-2026).
Building effective agents, Anthropic, 19-dic-2024 (consultada el 15-nov-2026).
How we built our multi-agent research system, Anthropic, 13-jun-2025 (consultada el 15-nov-2026).
Create custom subagents, documentación de Claude Code, Anthropic (consultada el 15-nov-2026).
A practical guide to building agents, OpenAI, lanzada el 17-abr-2025 según la cobertura de Maginative; el PDF no trae fecha (consultada el 15-nov-2026).
Workflow patterns, Agent Development Kit, Google (consultada el 15-nov-2026).
Presentación de Michell Lech (Piperz / Alpaca Labs) en Growth Lab 3ª edição, Florianópolis, 12-nov-2026. Datos tomados de la diapositiva.
También te puede interesar
Claude como centro de operaciones: cómo conectamos pauta, CRM y reportes en la agenciaPreguntas frecuentes
- ¿Qué es un equipo de agentes de IA para marketing? Es un conjunto de agentes de IA, cada uno con un rol (investigar, redactar, revisar, liberar), que trabajan sobre las mismas reglas escritas. Una persona aprueba lo que sale.
- ¿Por qué no alcanza con pedirle a la IA que revise su propio texto? Porque los modelos tienden a preferir sus propios textos y les cuesta autocorregirse sin una señal externa, según estudios de 2024 publicados en arXiv y presentados en ICLR.
- ¿Tengo que usar modelos distintos para redactar y revisar? No es obligatorio, pero ayuda: el sesgo de autopreferencia aparece cuando un modelo evalúa textos propios. Como mínimo, el revisor trabaja en otra sesión, sin el historial del redactor, y con una lista de control escrita.
- ¿Qué decisiones tiene que tomar siempre una persona? Las irreversibles o de alto impacto: publicar, cambiar precios, mover presupuesto de pauta, responder a un cliente por un reclamo. Así lo plantea la guía de OpenAI.
- ¿Cuánto cuesta un equipo de agentes? Depende del volumen. Como referencia, Anthropic informó que sus sistemas multiagente usan unas 15 veces más tokens que un chat, así que conviene empezar con dos agentes y medir.
Sobre el autor
Mariángeles Leiva Luque
Marketing & Comms · We make it Lab
Explorá más sobre