

Marketing
Time de agentes de IA para marketing: quem escreve não aprova

Mariángeles Leiva Luque
Publicado em · 9 min
A resposta curta
Um time de agentes de IA para marketing funciona quando cada agente tem um único papel e ninguém controla o próprio trabalho: um agente escreve, outro diferente revisa com uma lista fechada e uma pessoa aprova o que sai para o cliente ou para a loja. A regra tem respaldo: um estudo de Panickssery, Bowman e Feng publicado no arXiv em 2024 mostrou que os modelos de linguagem tendem a dar notas melhores aos próprios textos do que aos dos outros, mesmo quando avaliadores humanos consideram os dois de qualidade igual.
Anthropic, OpenAI e Google descrevem o mesmo esquema na documentação oficial para construir agentes: um gerador, um avaliador separado e pontos de controle humano para as decisões sensíveis. Aqui eu conto como aplicamos isso na agência para você copiar na sua loja virtual.
De onde vem a ideia: o time de agentes da Piperz
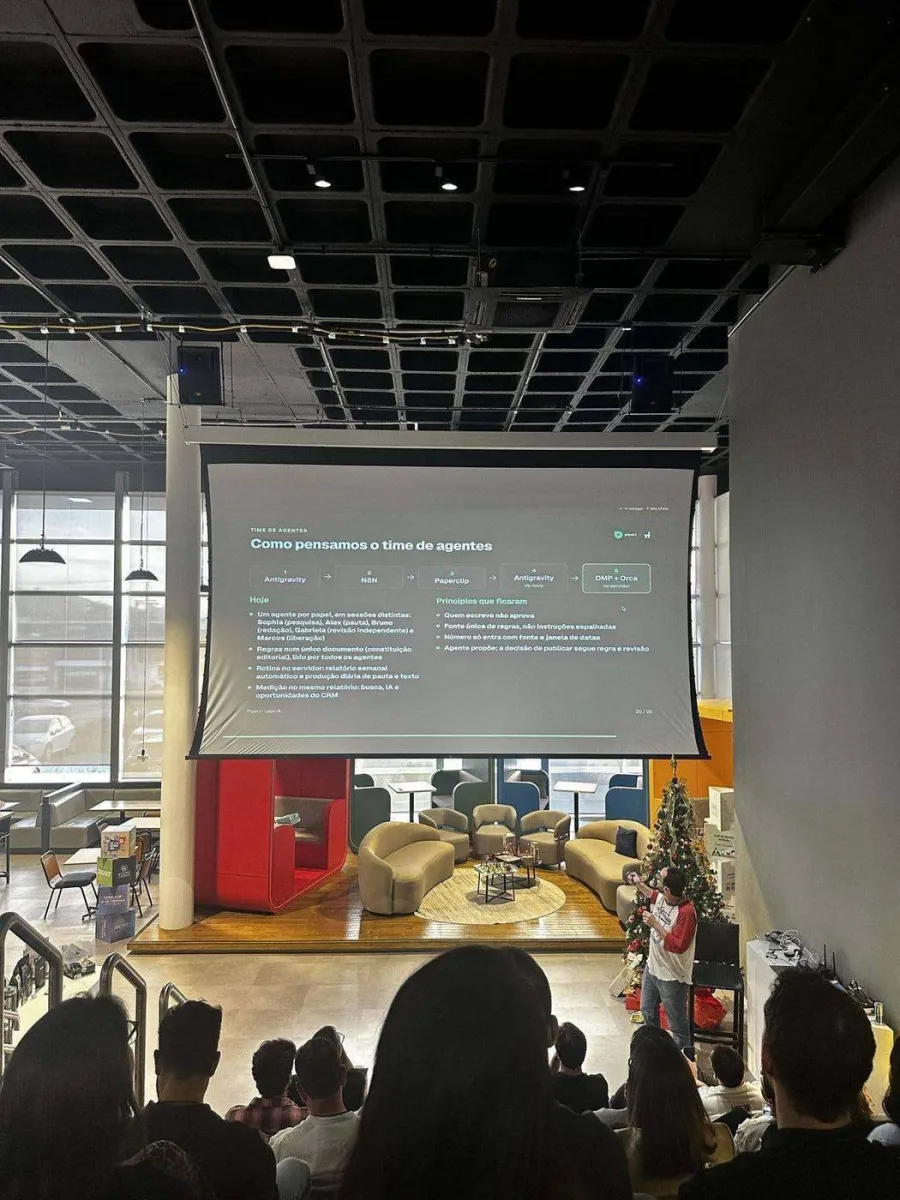
No dia 12 de novembro fui ao Growth Lab 3ª edição em Florianópolis (contei tudo em as 7 ideias que trouxe do Growth Lab). Michell Lech, CMO da Piperz e fundador da Alpaca Labs, mostrou como eles produzem conteúdo com um time de agentes.
Cada agente tem um papel e trabalha numa sessão separada: um pesquisa, outro monta a pauta editorial, outro escreve, outro faz uma revisão independente e outro libera a publicação. Todos leem as regras de um único documento, que eles chamam de constituição editorial. Os quatro princípios que ficaram depois de várias trocas de ferramenta foram estes:
Quem escreve não aprova.
Uma única fonte de regras, em vez de instruções espalhadas.
Número só entra com fonte e janela de datas.
O agente propõe; a decisão de publicar segue uma regra e uma revisão.
Para a sua loja: antes de adicionar ferramentas, escreva numa folha quem faz cada tarefa e quem controla. Se a mesma pessoa (ou o mesmo agente) faz as duas coisas, aí está o primeiro risco.
Por que quem escreve não pode aprovar
Três estudos com metodologia explicam isso.
O primeiro é o estudo sobre autopreferência que já citei. Os autores testaram modelos como GPT-4 e Llama 2 como avaliadores e encontraram um viés de autopreferência: o modelo dá nota melhor ao que ele mesmo escreveu. Além disso, quanto melhor ele se reconhece, mais forte é o viés.
O segundo foi apresentado na ICLR 2024 e se chama, traduzido, os modelos de linguagem ainda não conseguem autocorrigir seu raciocínio. A conclusão é que, sem um sinal externo, os modelos têm dificuldade para corrigir as próprias respostas e às vezes pioram depois de tentar.
O terceiro analisou por que falham os sistemas com vários agentes. Os autores da taxonomia MAST de falhas em sistemas multiagente (Cemri e outros, 2025) reuniram mais de 1.600 execuções anotadas em 7 frameworks populares e definiram 14 modos de falha. Uma das três categorias é a verificação da tarefa. Eles também alertam que, nos benchmarks populares, o ganho de usar vários agentes costuma ser mínimo: somar agentes sem desenho não garante nada.
| Estudo | O que mediu | O que significa para o seu time |
|---|---|---|
| Panickssery e outros, 2024 | Se um modelo prefere os próprios textos | O revisor tem que ser outro agente e, se possível, outro modelo |
| Huang e outros, ICLR 2024 | Se um modelo se corrige sozinho, sem ajuda externa | A revisão precisa de critérios externos (uma lista, uma fonte) |
| Cemri e outros, 2025 (MAST) | Por que falham os sistemas multiagente | A verificação é uma etapa própria, com dono |
O que fazer: pare de pedir ao mesmo chat "revise o que você escreveu". Abra outra sessão e passe só o texto e a lista de controle.
O que dizem Anthropic, OpenAI e Google
As três empresas concordam no desenho, cada uma com seu próprio nome para o padrão.
A Anthropic, no guia de engenharia sobre como construir agentes eficazes (dezembro de 2024), descreve o padrão avaliador e otimizador: um modelo gera uma resposta e outro avalia e devolve comentários num ciclo. O texto esclarece que funciona melhor quando há critérios de avaliação claros. Também recomenda começar pela solução mais simples possível e só aumentar a complexidade quando for necessário.
A OpenAI, no seu guia prático para construir agentes, lançado em abril de 2025, pede para planejar a intervenção humana em dois casos: quando o agente passa de um limite de tentativas e quando a ação é sensível, irreversível ou de alto impacto (os exemplos são cancelar pedidos, autorizar reembolsos grandes ou fazer pagamentos). A recomendação geral é tirar o máximo de um único agente antes de dividir o trabalho entre vários.
O Google, na documentação do Agent Development Kit sobre padrões de trabalho com vários agentes, lista o padrão de gerar e revisar (um agente gerador e um agente crítico), o refinamento iterativo com um número máximo de rodadas e o padrão com uma pessoa no circuito para supervisionar, aprovar ou corrigir.
| Empresa | Nome do padrão | O que recomenda |
|---|---|---|
| Anthropic | Avaliador e otimizador | Um modelo gera, outro avalia com critérios claros |
| OpenAI | Intervenção humana | Pessoa obrigatória em ações irreversíveis ou de alto impacto |
| Gerar e revisar, pessoa no circuito | Agente crítico separado e limite de iterações |
O que fazer: antes de montar qualquer coisa, escreva seus critérios de avaliação. Se você não consegue escrever o que está certo e o que está errado, o agente revisor também não vai conseguir decidir.
Como trabalhamos na We make it Lab
Na agência aplicamos a mesma regra de três passos nas entregas que passam por IA: textos do blog, copys, relatórios e peças para redes sociais.
Um agente escreve. Ele segue um manual escrito (a nossa versão da constituição editorial) com o tom, as fontes permitidas, o que é proibido dizer e o formato. Esse manual fica em skills do Claude, então não depende de alguém lembrar de colar as instruções.
Outro agente, diferente, faz o controle de qualidade. Ele roda numa sessão separada, sem o histórico do redator. No Claude Code isso se resolve com subagentes, que segundo a documentação da Anthropic rodam na própria janela de contexto e com permissões independentes. O revisor confere com uma lista: se cumpre o pedido, acentuação, se cada número tem fonte, se os links funcionam e se não há marcas típicas de texto feito com IA. Ele tem no máximo duas rodadas. Se depois disso ainda houver erros, a entrega fica marcada para revisão e não avança.
Uma pessoa aprova o que vai para o cliente. A account manager ou eu olhamos o resultado antes de enviar. O mesmo vale para as contas de anúncios: um agente pode ler os dados da Meta ou do Google (contamos como conectamos em como conectar o Claude ao seu CRM ou ERP com MCP), mas aumentar um orçamento ou pausar uma campanha é decisão de uma pessoa.
Este artigo passou por esse mesmo circuito antes de chegar ao blog.
O que fazer: se você já usa IA no seu time, acrescente um único passo: um revisor separado com uma lista de dez pontos. Na agência foi a mudança mais simples de implementar.
Como montar seu time de agentes em 5 passos
Para uma loja virtual, o time completo tem quatro papéis:
| Papel | O que faz | O que não pode fazer | Exemplo numa loja |
|---|---|---|---|
| Pesquisador | Junta dados com fonte | Escrever o texto final | Revisa perguntas frequentes e avaliações |
| Redator | Escreve seguindo o manual | Aprovar o próprio texto | Monta a página de produto ou o e-mail |
| Revisor | Confere com a lista | Reescrever o estilo por gosto | Verifica preço, parcelamento, frete e ortografia |
| Pessoa aprovadora | Decide o que sai | Delegar o que é irreversível | Publica a página ou lança a campanha |
Escolha uma tarefa repetível. Páginas de produto, copys de anúncios ou e-mails pós-compra. Uma só para começar: tanto a Anthropic quanto a OpenAI recomendam começar simples.
Escreva a constituição. Um documento único com tom, claims proibidos, de onde saem preços e parcelamento e quais dados precisam de fonte. Explicamos isso em como implementar o Claude numa empresa.
Separe redator e revisor. Sessões diferentes, e o revisor recebe só o texto e a lista.
Defina o que uma pessoa sempre aprova. Tudo o que chega ao cliente final, os preços e qualquer mudança de orçamento no tráfego pago da sua loja.
Coloque um limite de rodadas e meça o custo. A Anthropic informou no artigo sobre seu sistema de pesquisa com vários agentes (junho de 2025) que esse sistema superou em 90,2 % um agente sozinho na avaliação interna, mas que sistemas multiagente usam cerca de 15 vezes mais tokens que um chat.
O que fazer: comece com redator e revisor. Adicione pesquisador e orquestrador só se o volume pedir.
O que não fazer
Instruções espalhadas em dez prompts. Quando uma regra muda, ninguém sabe onde atualizar. Uma única fonte.
Deixar um agente publicar ou mexer em orçamento sem uma pessoa. Mexer em dinheiro é o tipo de ação que a OpenAI classifica como de alto risco.
Começar com seis agentes. Mais agentes somam custo e pontos de falha, como mostra o estudo MAST.
Números sem fonte. Se o revisor não consegue abrir a fonte e confirmar o dado, o dado não entra.
Conclusão
Um time de agentes de IA para marketing rende quando separa papéis: um produz, outro controla com critérios escritos e uma pessoa decide o que mexe com dinheiro ou chega ao cliente. É a regra que a Piperz mostrou no Growth Lab e a que aparece na documentação da Anthropic, da OpenAI e do Google.
Se você quer levar esse esquema para o seu time, temos uma capacitação em Claude Code para times e montamos automações sob medida. E se você tem uma loja virtual e quer saber onde o dinheiro está escapando no tráfego pago, peça um diagnóstico da sua conta de 30 minutos.
Fontes consultadas
LLM Evaluators Recognize and Favor Their Own Generations, Panickssery, Bowman e Feng, arXiv, abril de 2024 (consultado em 15-nov-2026).
Large Language Models Cannot Self-Correct Reasoning Yet, Huang e outros, ICLR 2024 (consultado em 15-nov-2026).
Why Do Multi-Agent LLM Systems Fail?, Cemri e outros, arXiv, março de 2025, revisão de outubro de 2025 (consultado em 15-nov-2026).
Building effective agents, Anthropic, 19-dez-2024 (consultado em 15-nov-2026).
How we built our multi-agent research system, Anthropic, 13-jun-2025 (consultado em 15-nov-2026).
Create custom subagents, documentação do Claude Code, Anthropic (consultado em 15-nov-2026).
A practical guide to building agents, OpenAI, lançado em 17-abr-2025 segundo a cobertura da Maginative; o PDF não traz data (consultado em 15-nov-2026).
Workflow patterns, Agent Development Kit, Google (consultado em 15-nov-2026).
Apresentação de Michell Lech (Piperz / Alpaca Labs) no Growth Lab 3ª edição, Florianópolis, 12-nov-2026. Dados tirados do slide.
Você também pode gostar
Claude como central de operações: como conectamos anúncios, CRM e relatóriosPerguntas frequentes
- O que é um time de agentes de IA para marketing? É um conjunto de agentes de IA, cada um com um papel (pesquisar, escrever, revisar, liberar), que trabalham sobre as mesmas regras escritas. Uma pessoa aprova o que sai.
- Por que não basta pedir para a IA revisar o próprio texto? Porque os modelos tendem a preferir os próprios textos e têm dificuldade para se autocorrigir sem um sinal externo, segundo estudos de 2024 publicados no arXiv e apresentados na ICLR.
- Preciso usar modelos diferentes para escrever e revisar? Não é obrigatório, mas ajuda: o viés de autopreferência aparece quando um modelo avalia textos próprios. No mínimo, o revisor trabalha em outra sessão, sem o histórico do redator, e com uma lista de controle escrita.
- Quais decisões uma pessoa sempre tem que tomar? As irreversíveis ou de alto impacto: publicar, mudar preços, mexer no orçamento de mídia, responder a um cliente sobre uma reclamação. É o que propõe o guia da OpenAI.
- Quanto custa um time de agentes? Depende do volume. Como referência, a Anthropic informou que seus sistemas multiagente usam cerca de 15 vezes mais tokens que um chat, então vale começar com dois agentes e medir.
Sobre o autor
Mariángeles Leiva Luque
Marketing & Comms · We make it Lab
Explore mais sobre